
Use o cache de prompts com modelos de pesos abertos no Amazon (nova aba) Bedrock
Anúncio da empresa · Fonte primária
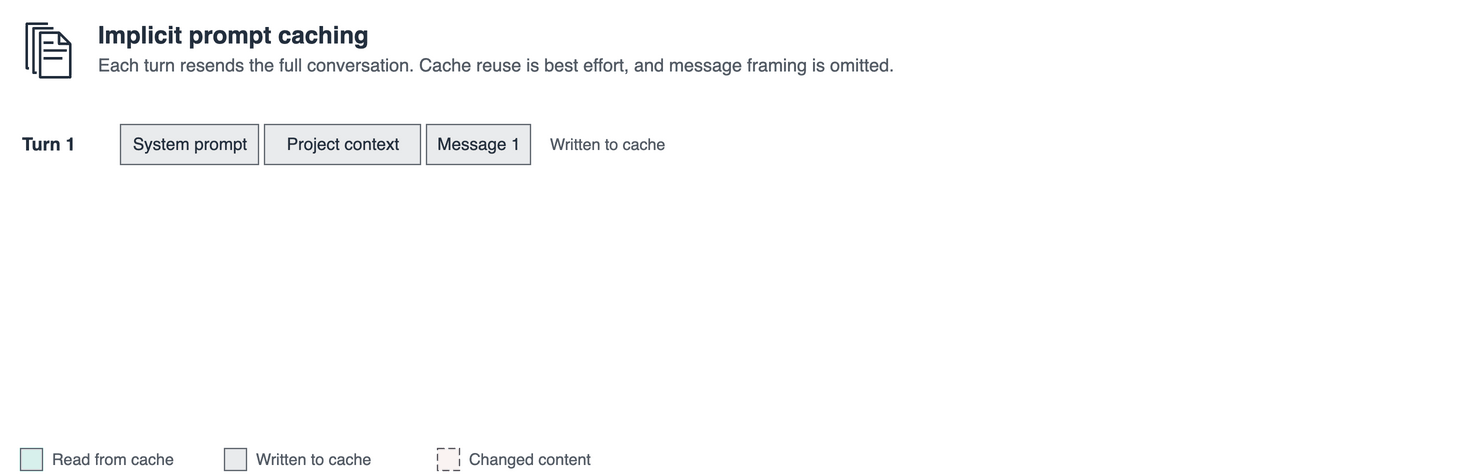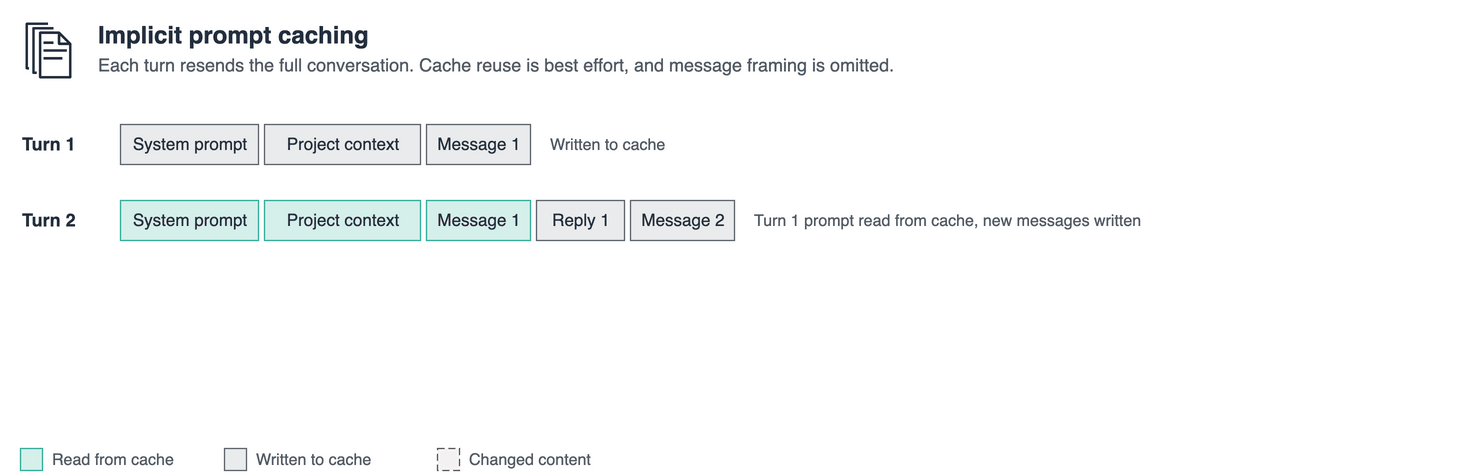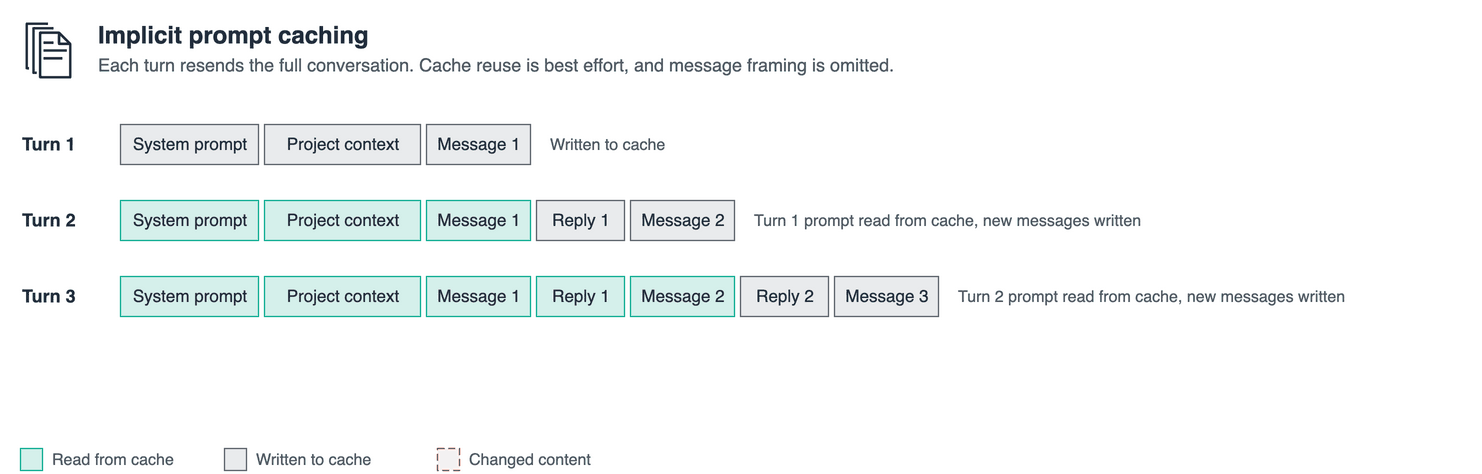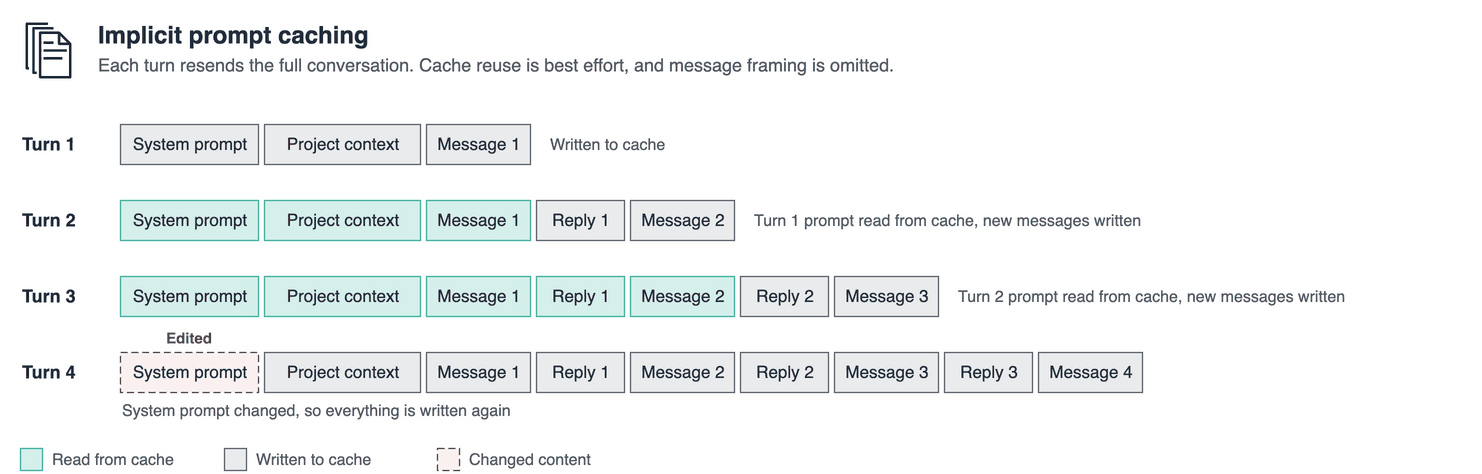
Muitos aplicativos de IA generativa reenviam o mesmo contexto longo em cada solicitação. O cache de prompts permite que modelos de pesos abertos no Amazon (nova aba) Bedrock o reutilizem para reduzir o custo de entrada e a latência. Este post demonstra o cache implícito e explícito por meio da API de Completions de Chat e aplica o cache a uma sessão do agente de codificação OpenCode.
Ler mais (nova aba)Tradução do trecho disponibilizado pela fonte · validação automática
 Amazon