
O SageMaker Inference agora suporta Multi-Instance GPU para maximizar a utilização de GPUs em endpoints de modelos
Anúncio da empresa · Fonte primária
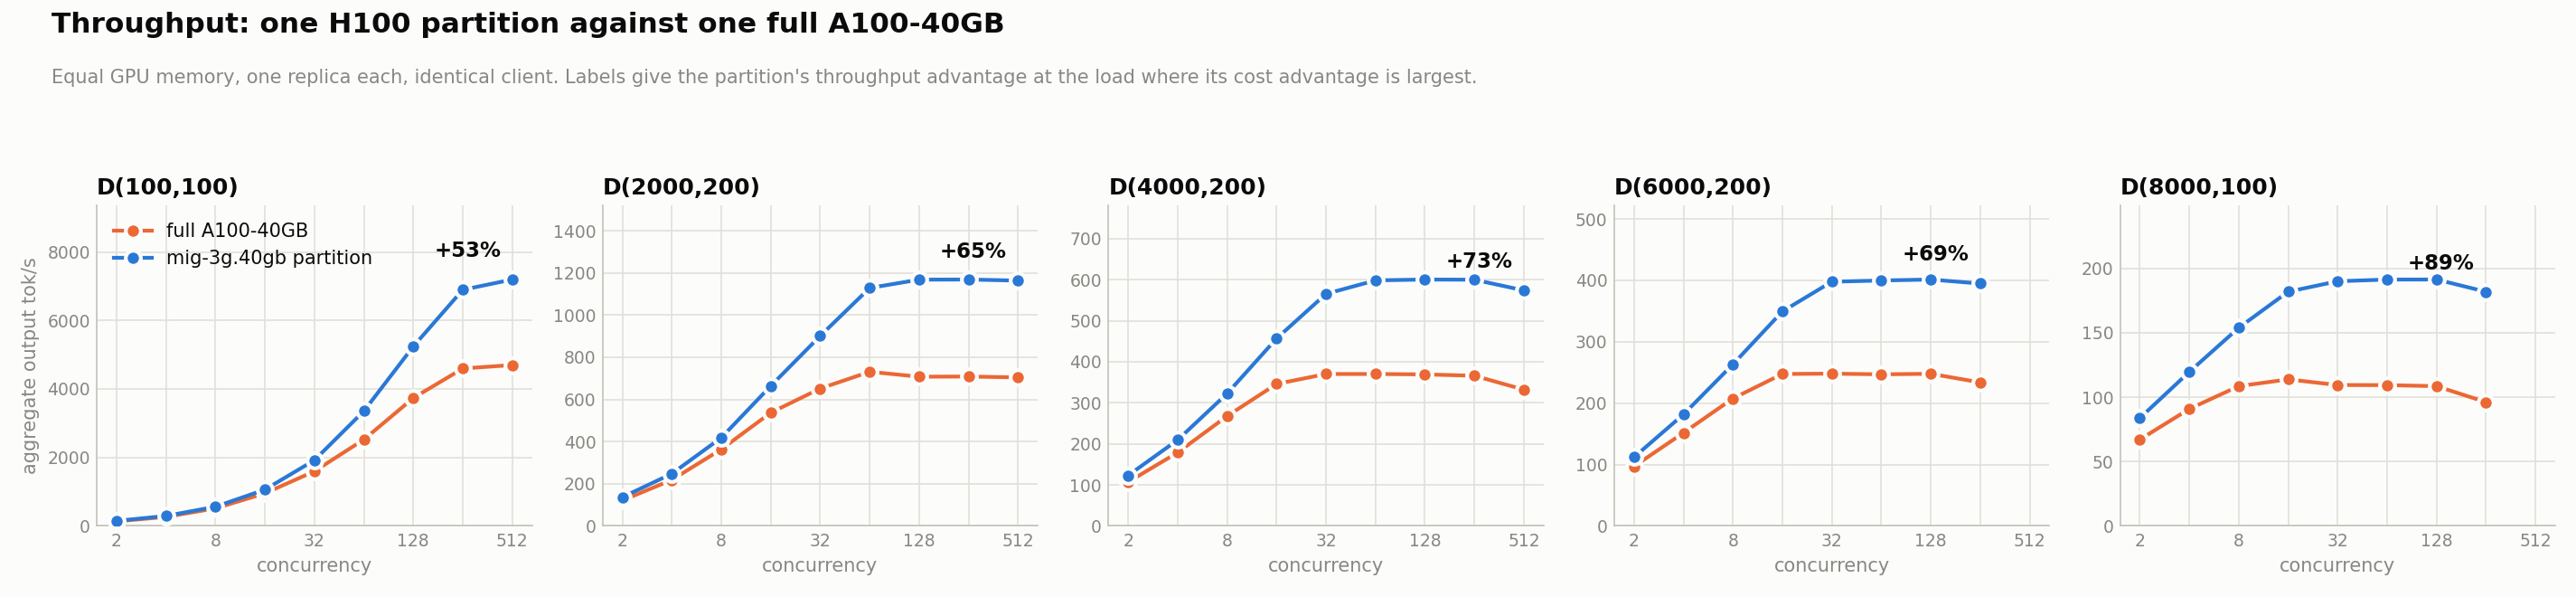
O Amazon (nova aba) SageMaker Inference agora suporta particionamento de GPU com NVIDIA (nova aba) Multi-Instance GPU (MIG), que divide uma GPU em partições isoladas por hardware, permitindo executar um modelo diferente em cada uma ou utilizar uma fração dimensionada adequadamente de um acelerador mais recente. Este post mostra como dois campos opcionais da API posicionam um modelo por partição e o que medimos em comparação com uma GPU antiga inteira.
Ler mais (nova aba)Tradução do trecho disponibilizado pela fonte · validação automática
 Amazon