
Inferência de fala para texto da AssemblyAI com otimização de custos na AWS usando Amazon (nova aba) EC2 Spot
Anúncio da empresa · Fonte primária
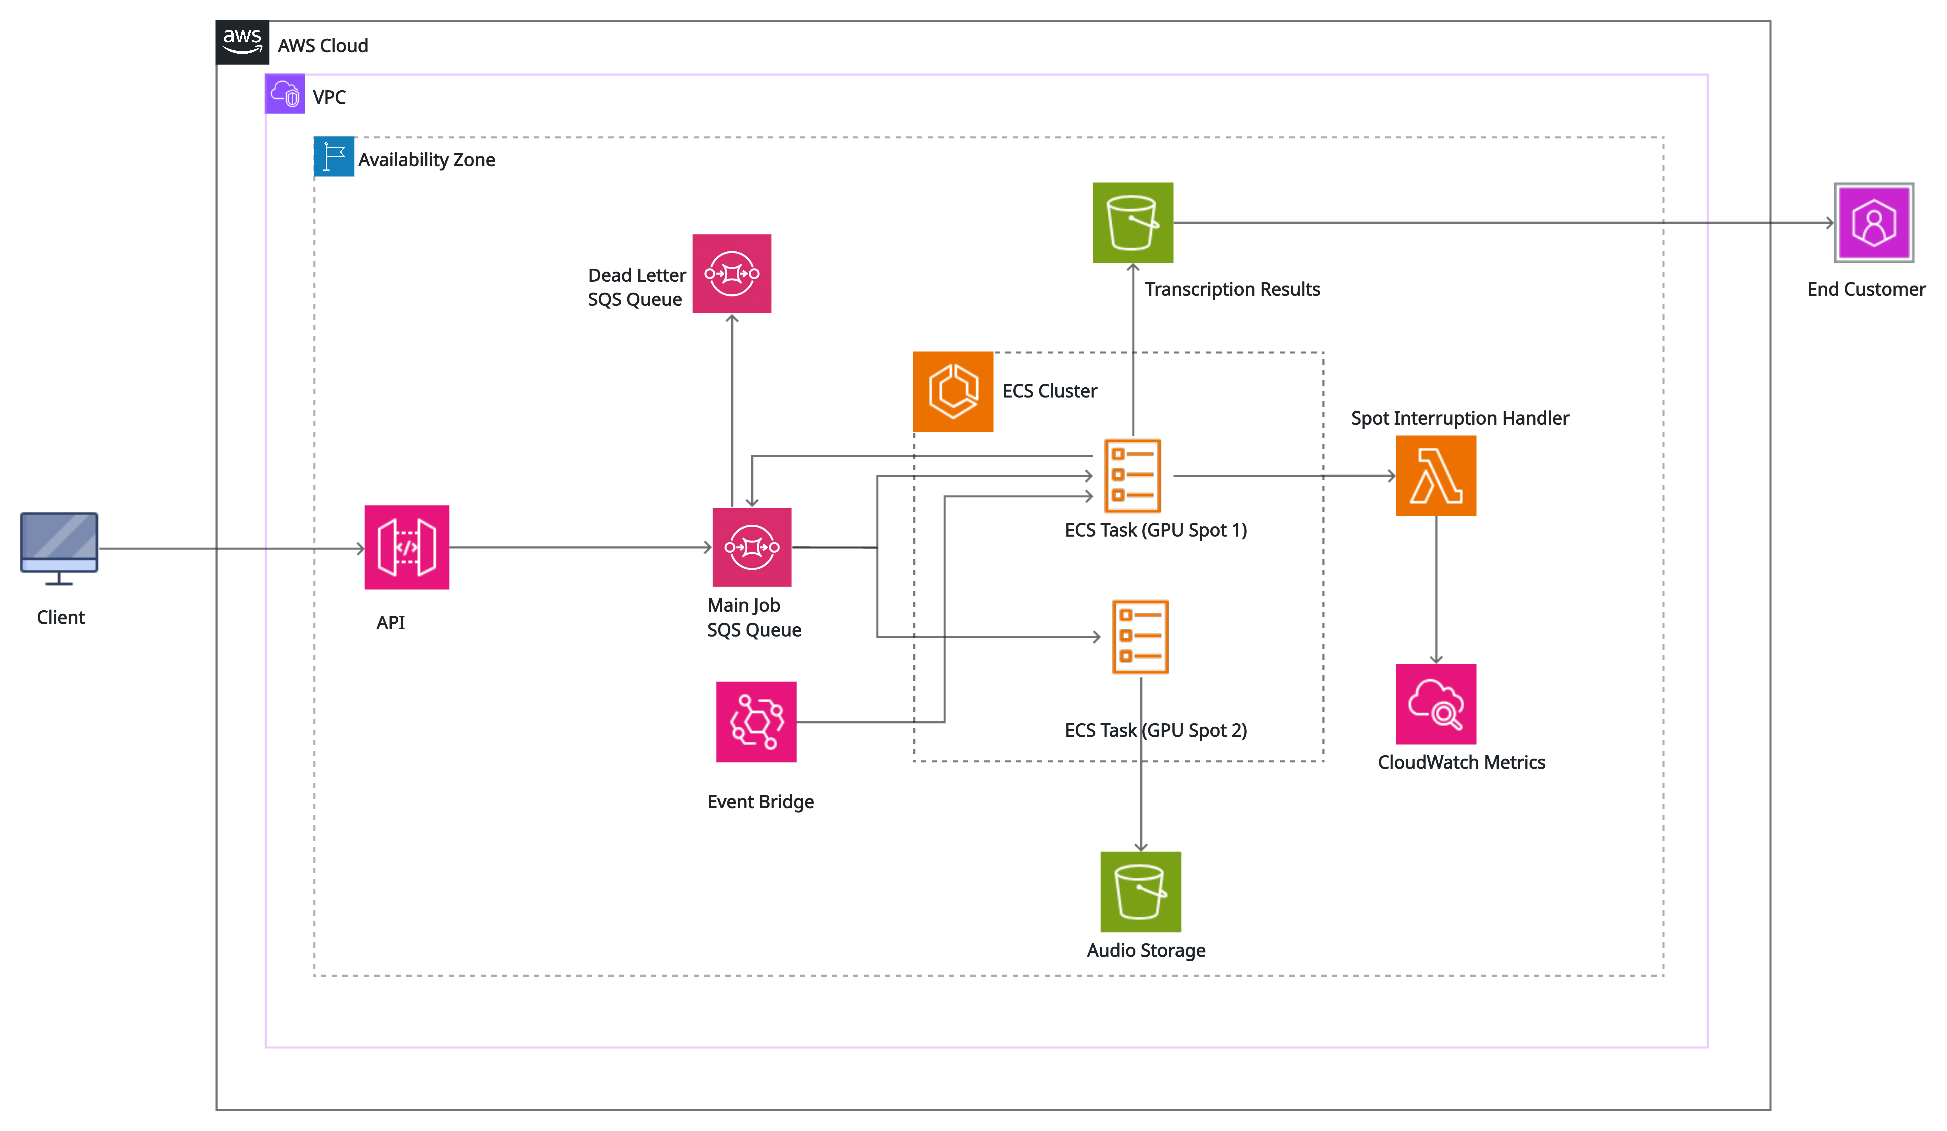
Aprenda como a AssemblyAI executa inferência de fala para texto com otimização de custos em larga escala na AWS, utilizando instâncias GPU Amazon (nova aba) EC2 Spot, Amazon ECS e uma arquitetura de repetição baseada em Amazon SQS para alcançar uma economia de 70% nos custos, mantendo os compromissos de SLA em regiões europeias.
Ler mais (nova aba)Tradução do trecho disponibilizado pela fonte · validação automática
 Amazon